5 học sinh và hành trình “hồi sinh” chữ Thái cổ bằng công nghệ
Từ những trang sách cổ ở Bảo tàng Sơn La đến lớp học của học sinh vùng cao, 5 học sinh lớp 11 chuyên Tin ở Hà Nội đang tìm cách giúp chữ Thái cổ được đọc, học và sử dụng thuận tiện hơn trên môi trường số.
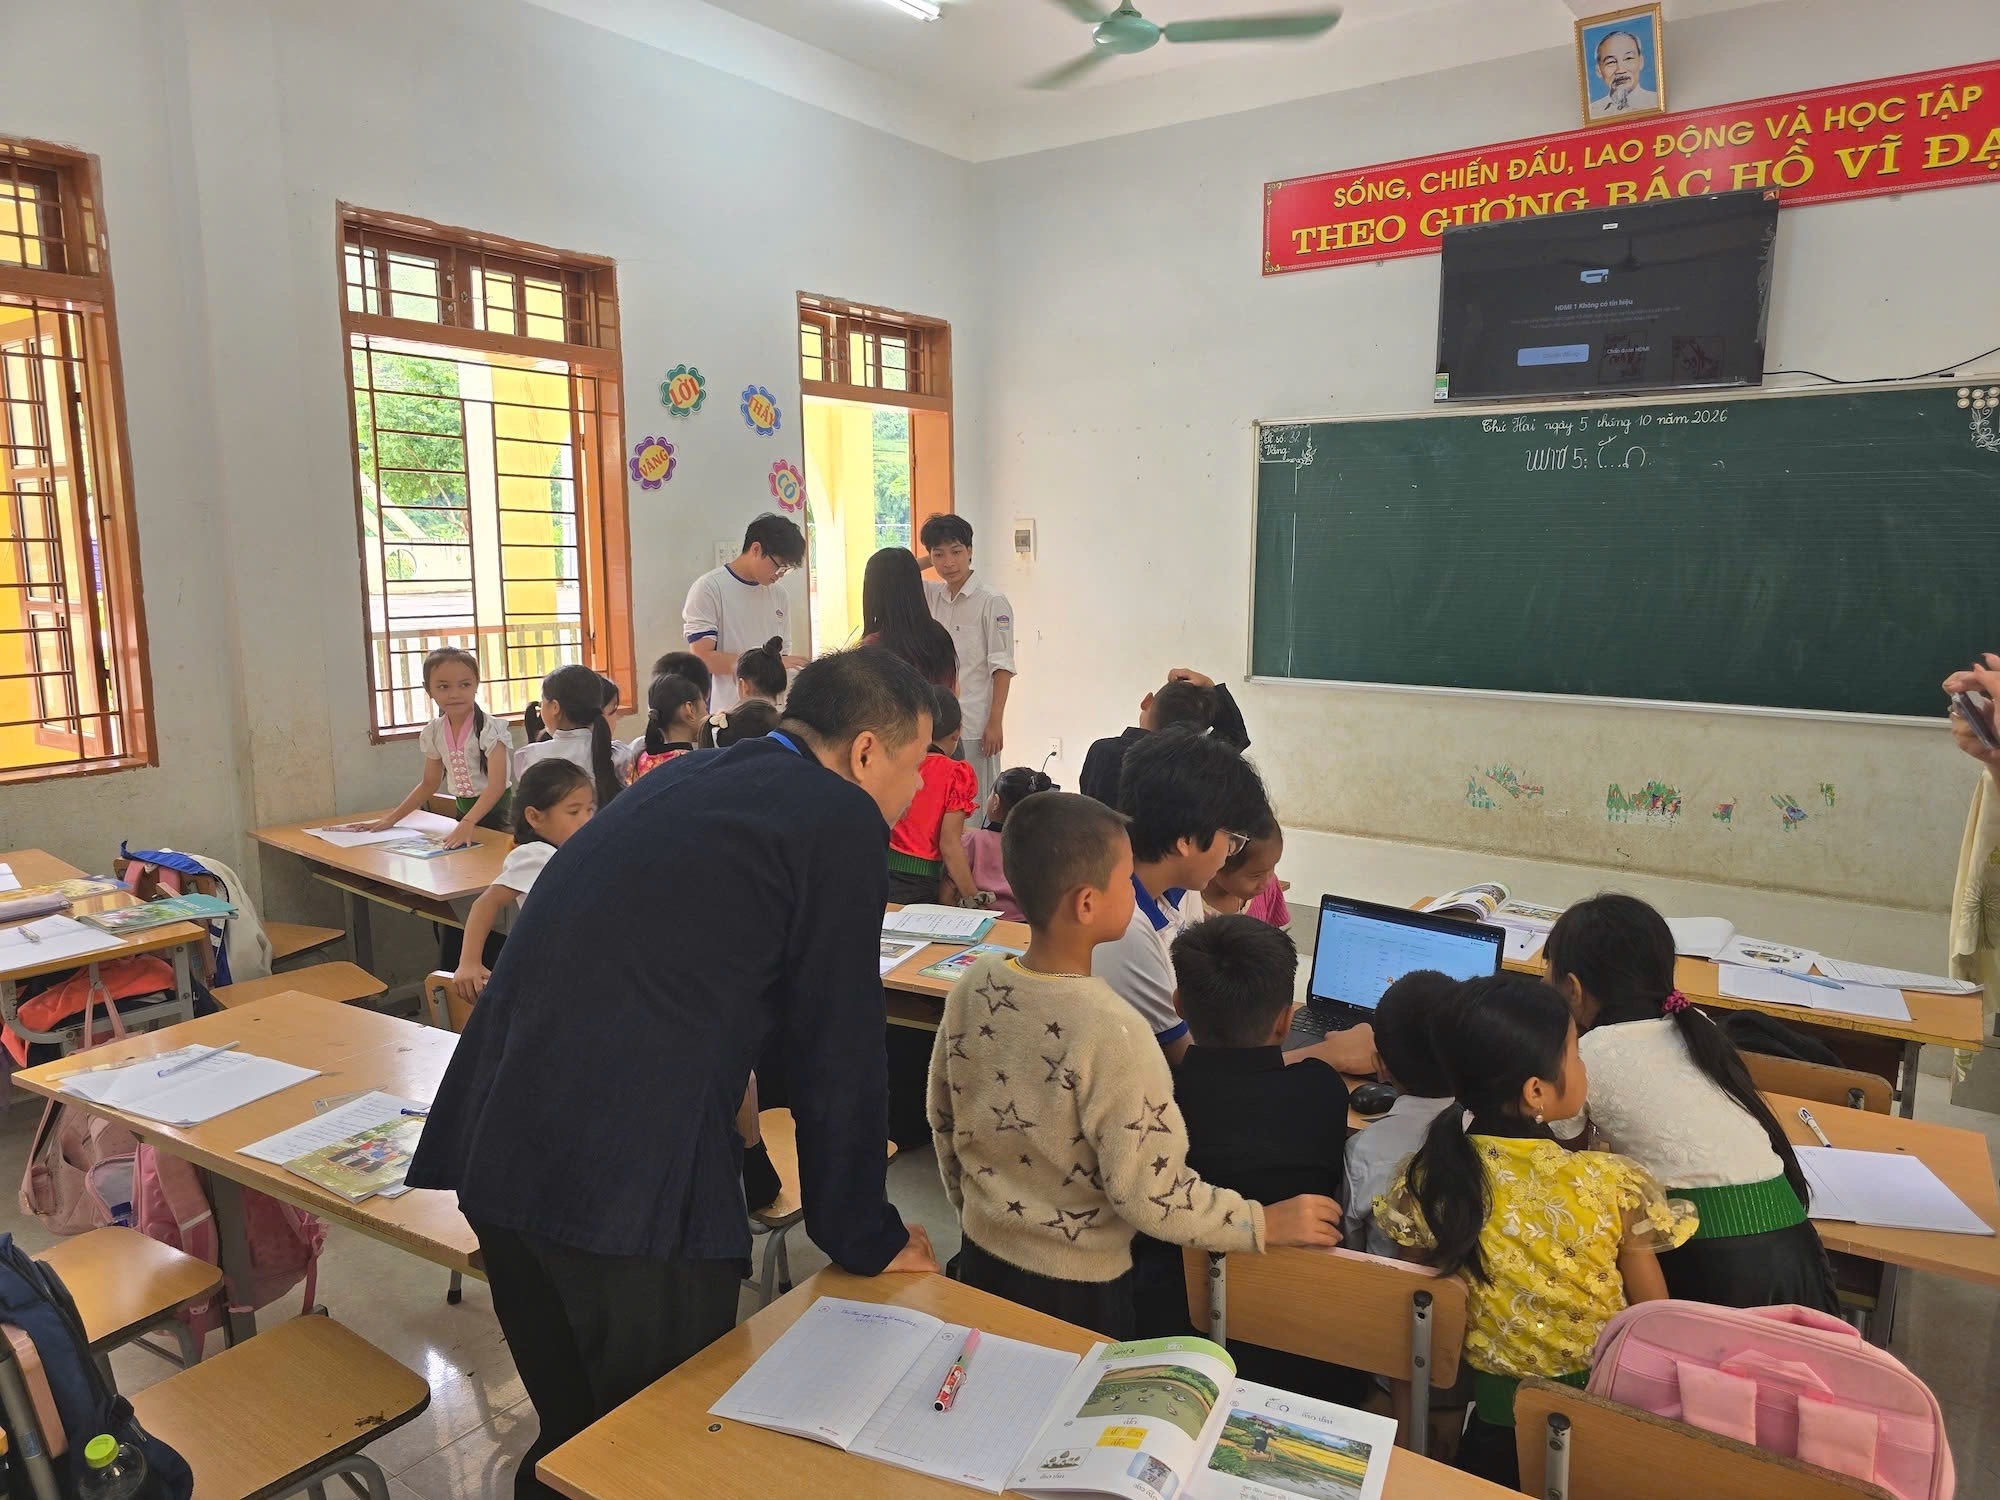
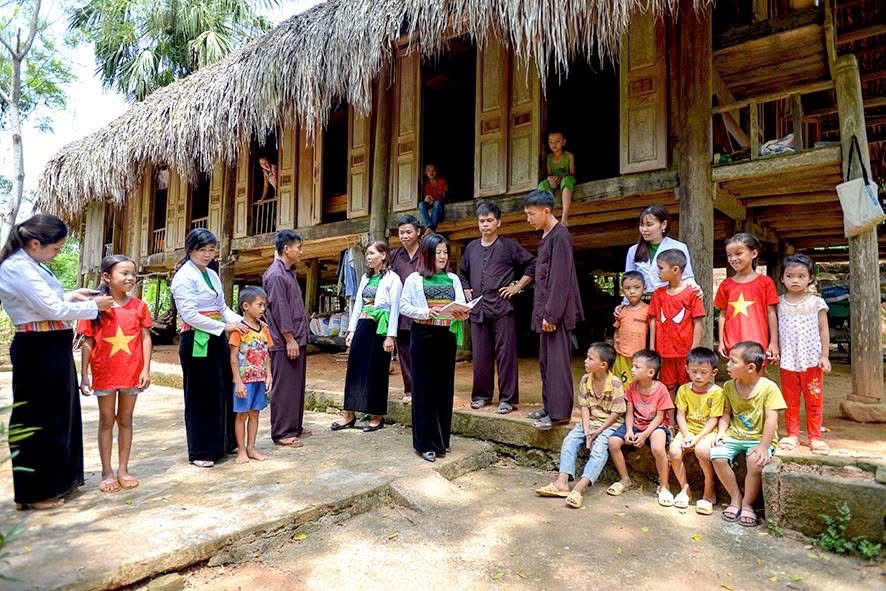
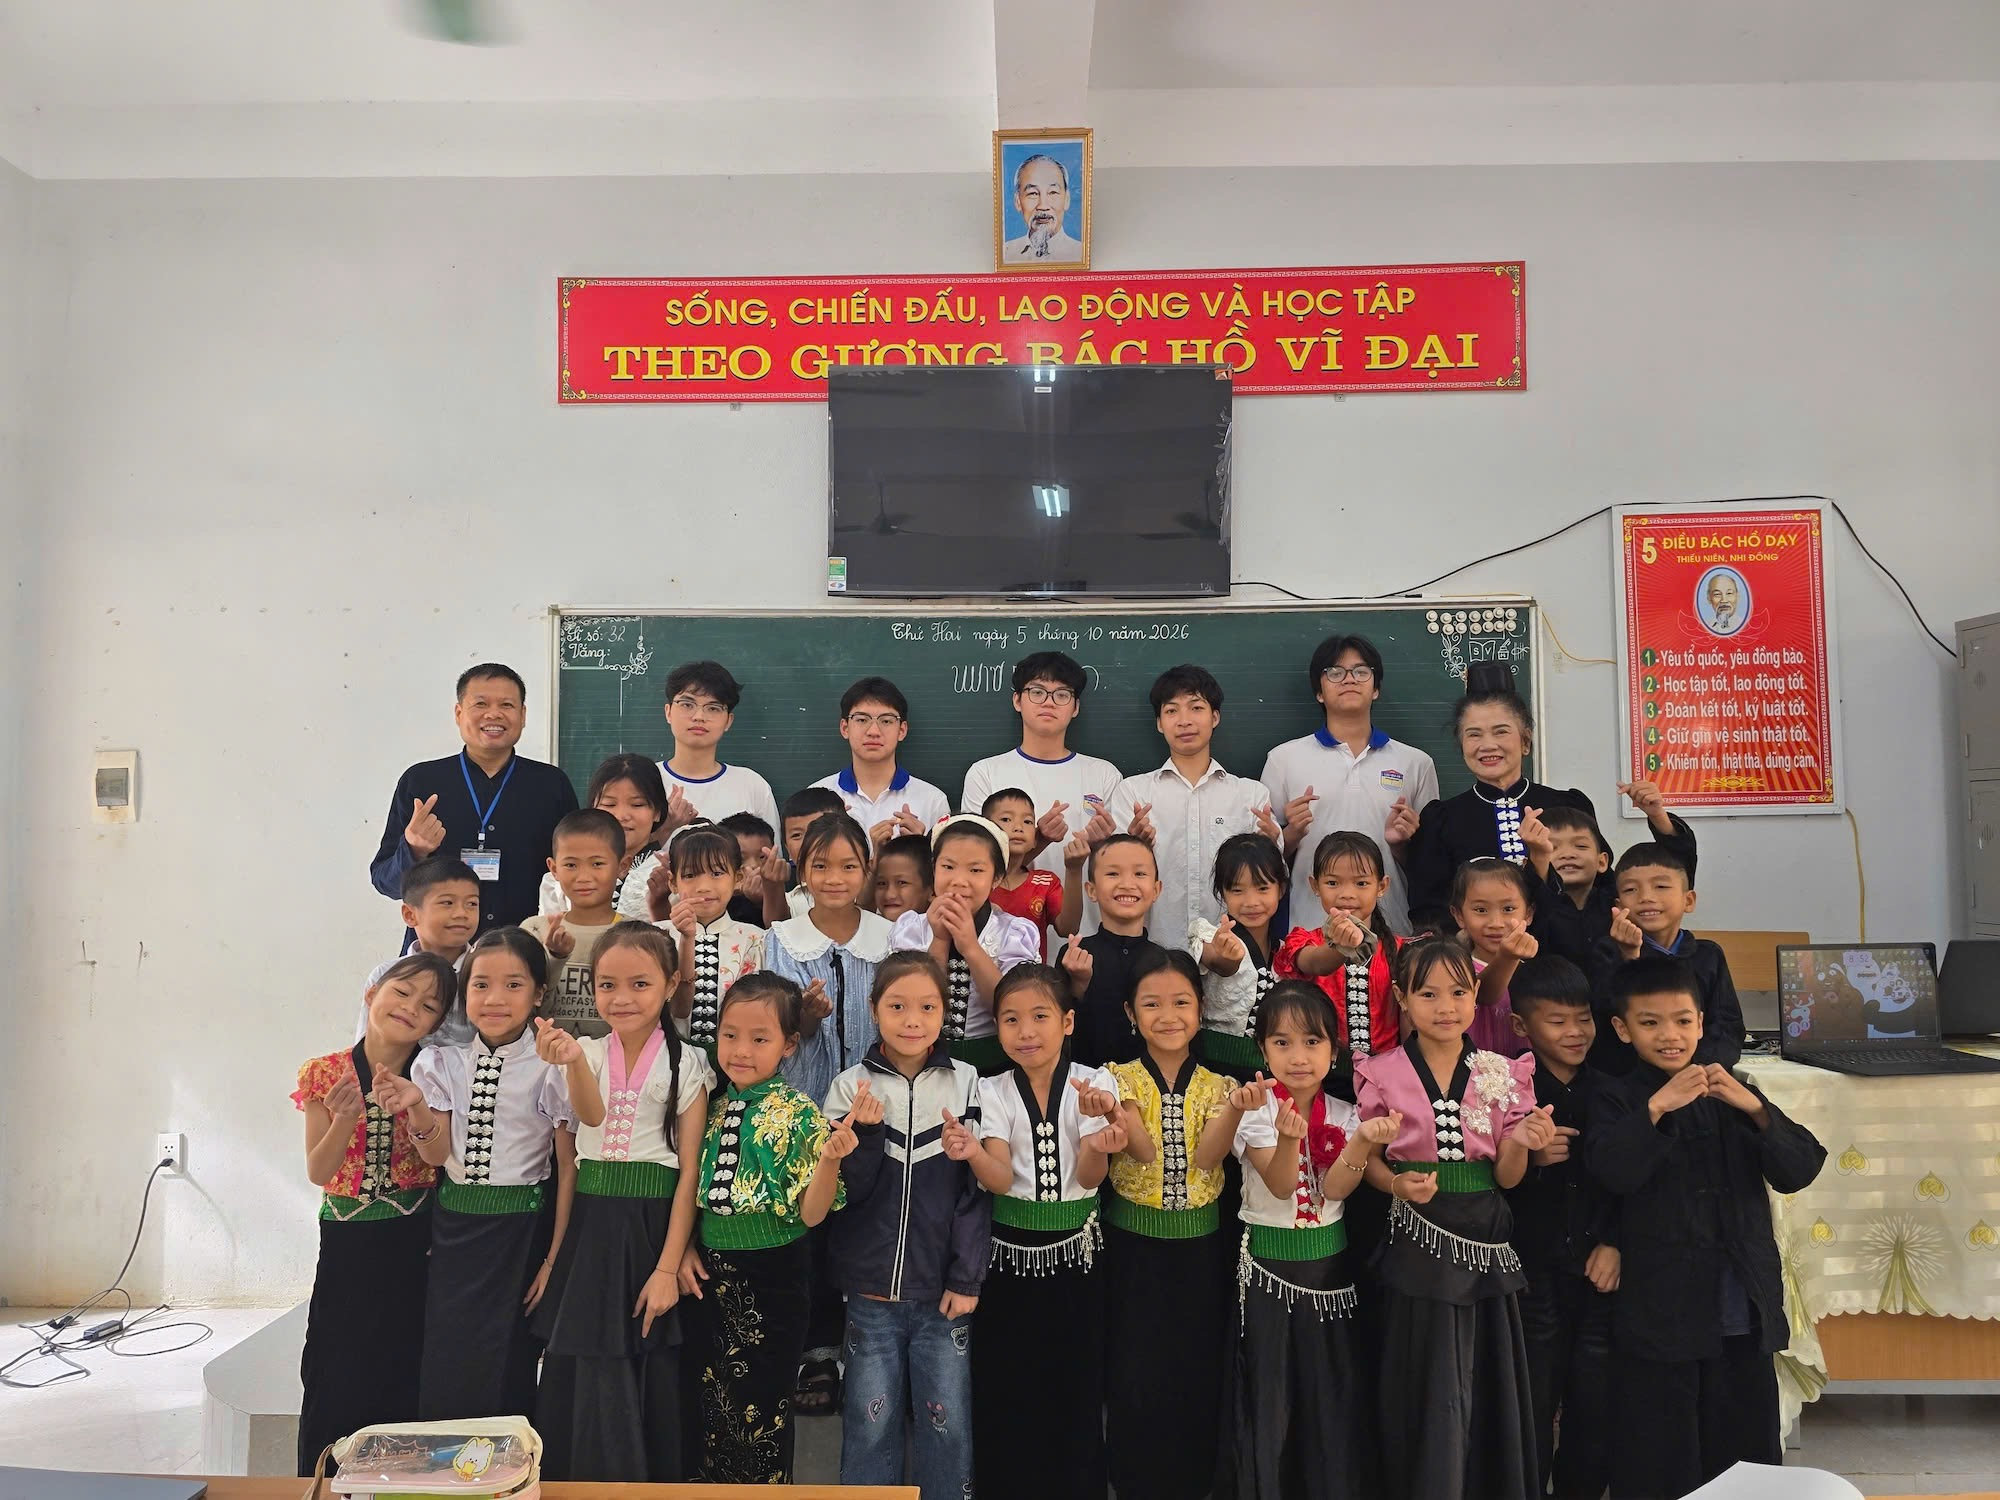
Trong một buổi học tiếng Thái tại Trường Nậm Păm, Sơn La, những học sinh địa phương không chỉ tập đọc, tập viết chữ của dân tộc mình mà còn thử đưa những con chữ ấy lên điện thoại, máy tính.
Bên cạnh các em là Ngô Hoàng Long, Phạm Mạnh Phong, Nguyễn Trí Minh, Lê Minh Sơn và Trần Gia Bảo - 5 học sinh lớp 11 chuyên Tin, Trường THPT chuyên Chu Văn An, Hà Nội.
Các em mang đến VietTrans, một nền tảng đang được xây dựng để nhận dạng chữ Thái cổ từ hình ảnh, chuyển đổi văn bản, tra cứu từ ngữ và dịch giữa tiếng Thái Đen với tiếng Việt.
Nhưng điều nhóm học sinh quan tâm không chỉ là làm ra một sản phẩm công nghệ.
Điều các em muốn tìm lời giải là: Khi đời sống ngày càng chuyển lên môi trường số, làm thế nào để một chữ viết truyền thống cũng có thể đi cùng cộng đồng vào không gian ấy?
Giữ chữ Thái cổ không chỉ bằng cách cất giữ
Trong nhiều gia đình người Thái, những cuốn sách viết bằng chữ Thái cổ vẫn được gìn giữ qua nhiều thế hệ. Đó có thể là truyện thơ, sử thi, sách ghi phong tục, nghi lễ, tri thức dân gian hay những ghi chép của cha ông.
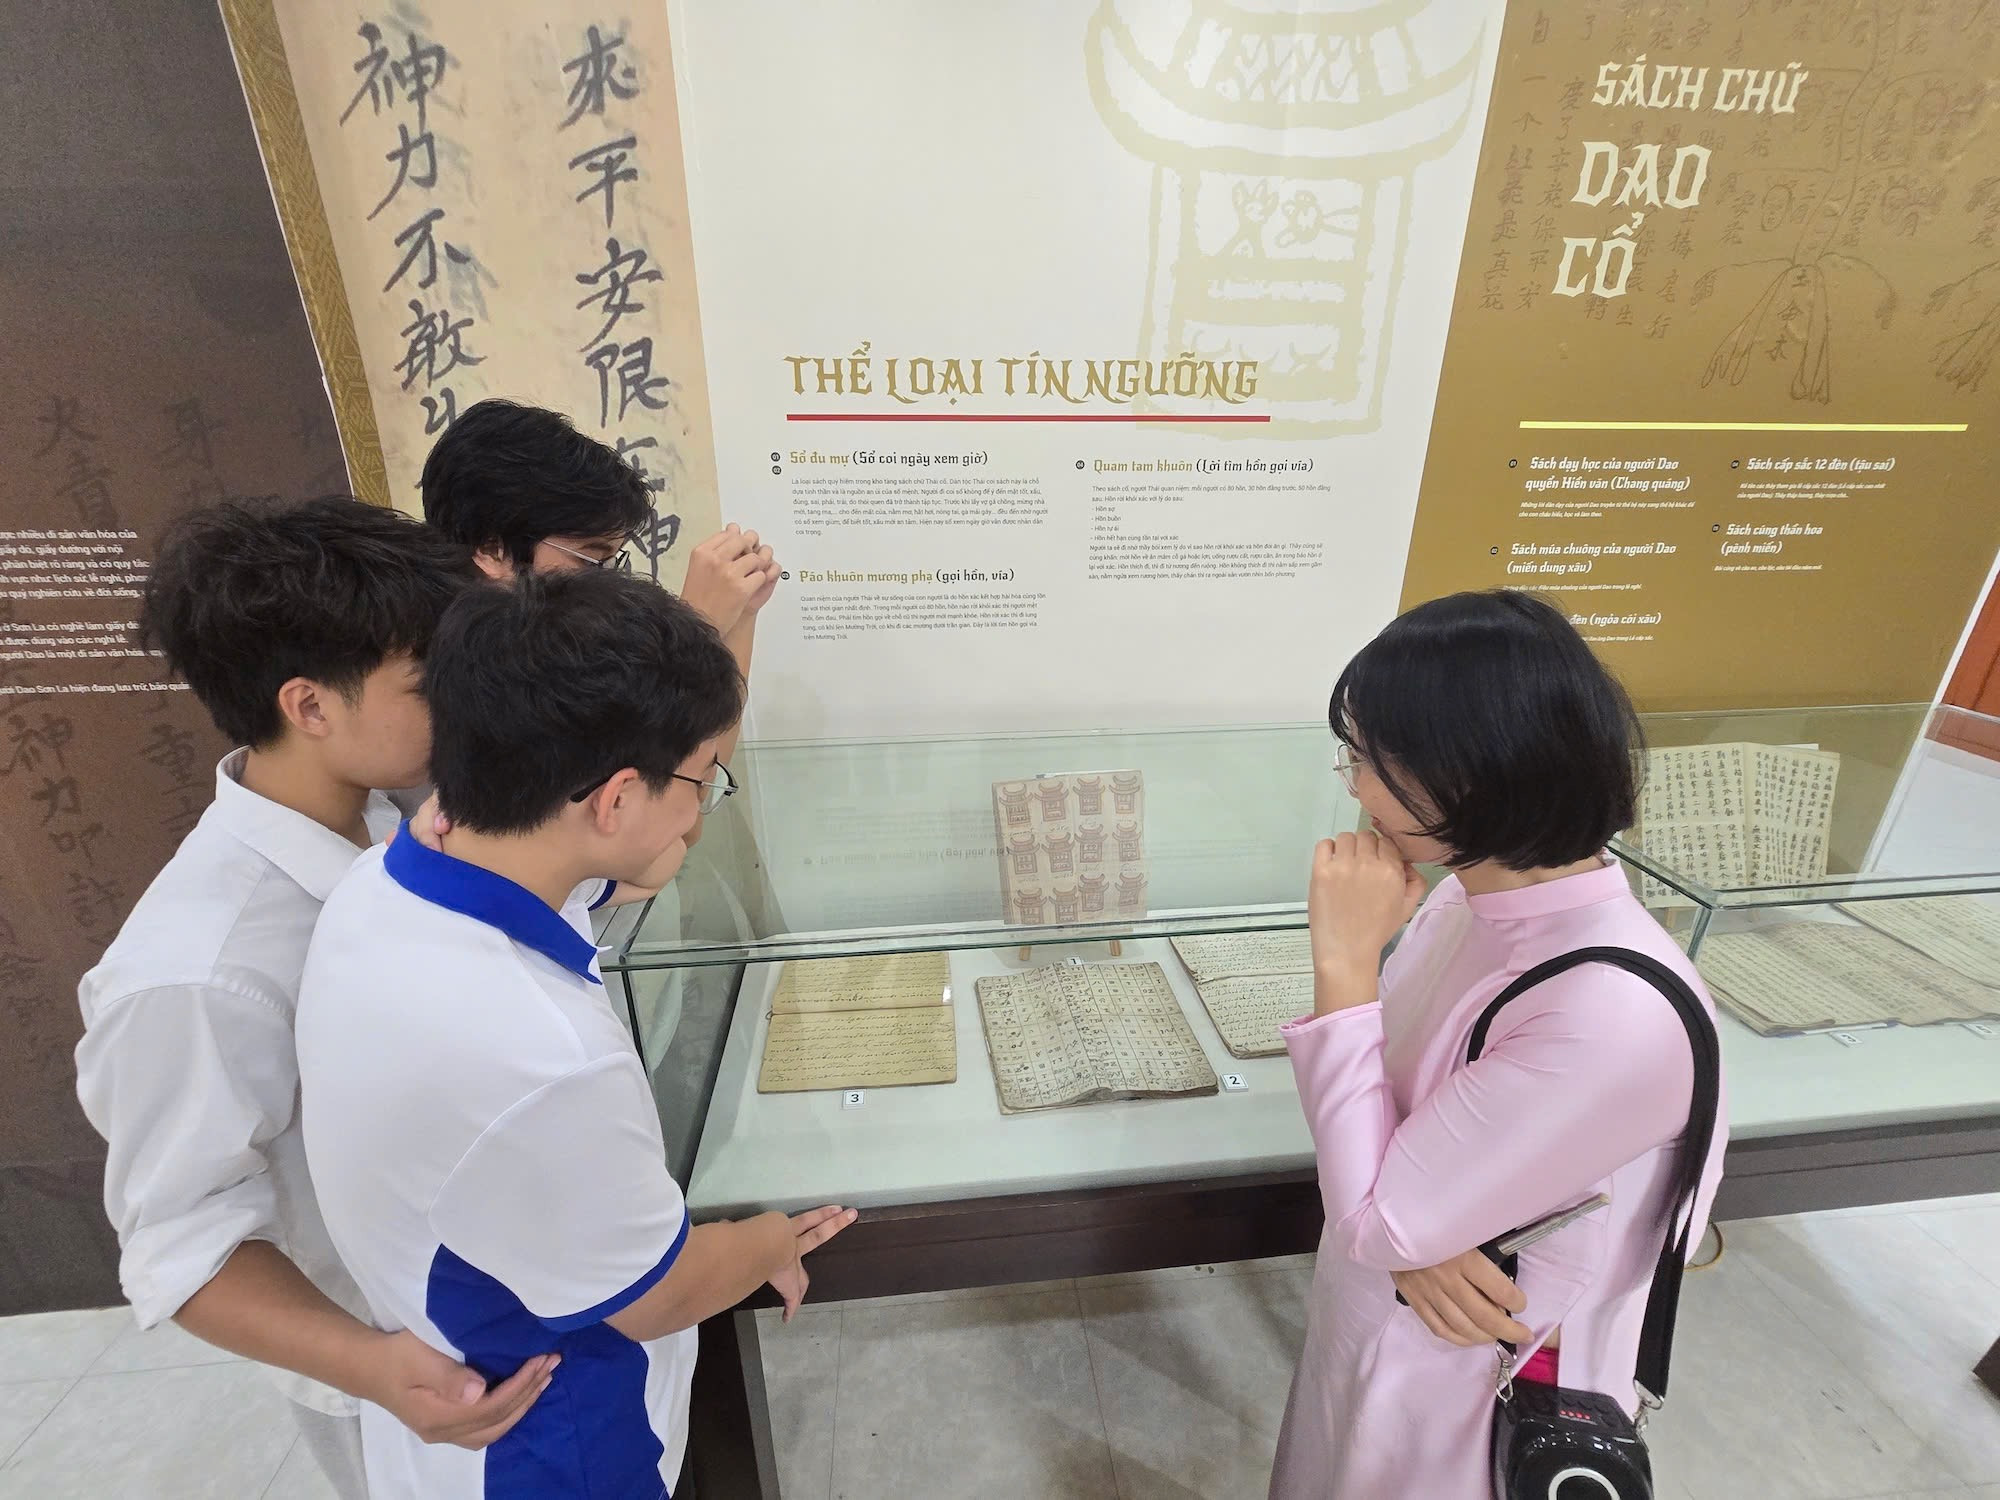
Tại các bảo tàng, thư viện và cơ sở nghiên cứu, nhiều tài liệu cũng đang được sưu tầm, bảo quản và từng bước số hóa.
Tuy nhiên, theo nhóm VietTrans, bảo quản được văn bản mới chỉ là một phần của câu chuyện.
Một chữ viết chỉ thực sự có sức sống khi vẫn còn người học, người đọc và người sử dụng nó.
Ngô Hoàng Long - Trưởng nhóm, cho rằng nếu chữ Thái chỉ tồn tại trong sách cổ, hoặc các kho lưu trữ mà ngày càng xa rời đời sống của thế hệ trẻ, khoảng cách giữa di sản và cộng đồng sẽ ngày càng lớn.
“Bọn em không muốn chữ Thái chỉ nằm trong bảo tàng. Một ngôn ngữ muốn sống thì phải có người sử dụng hằng ngày. Công nghệ có thể giúp việc học, đọc và sử dụng chữ thuận tiện hơn”, Long chia sẻ.
Ý tưởng ấy đã đưa 5 học sinh Hà Nội từ phòng máy tính đến những lớp học, bảo tàng và những người đang trực tiếp nghiên cứu, truyền dạy chữ Thái.
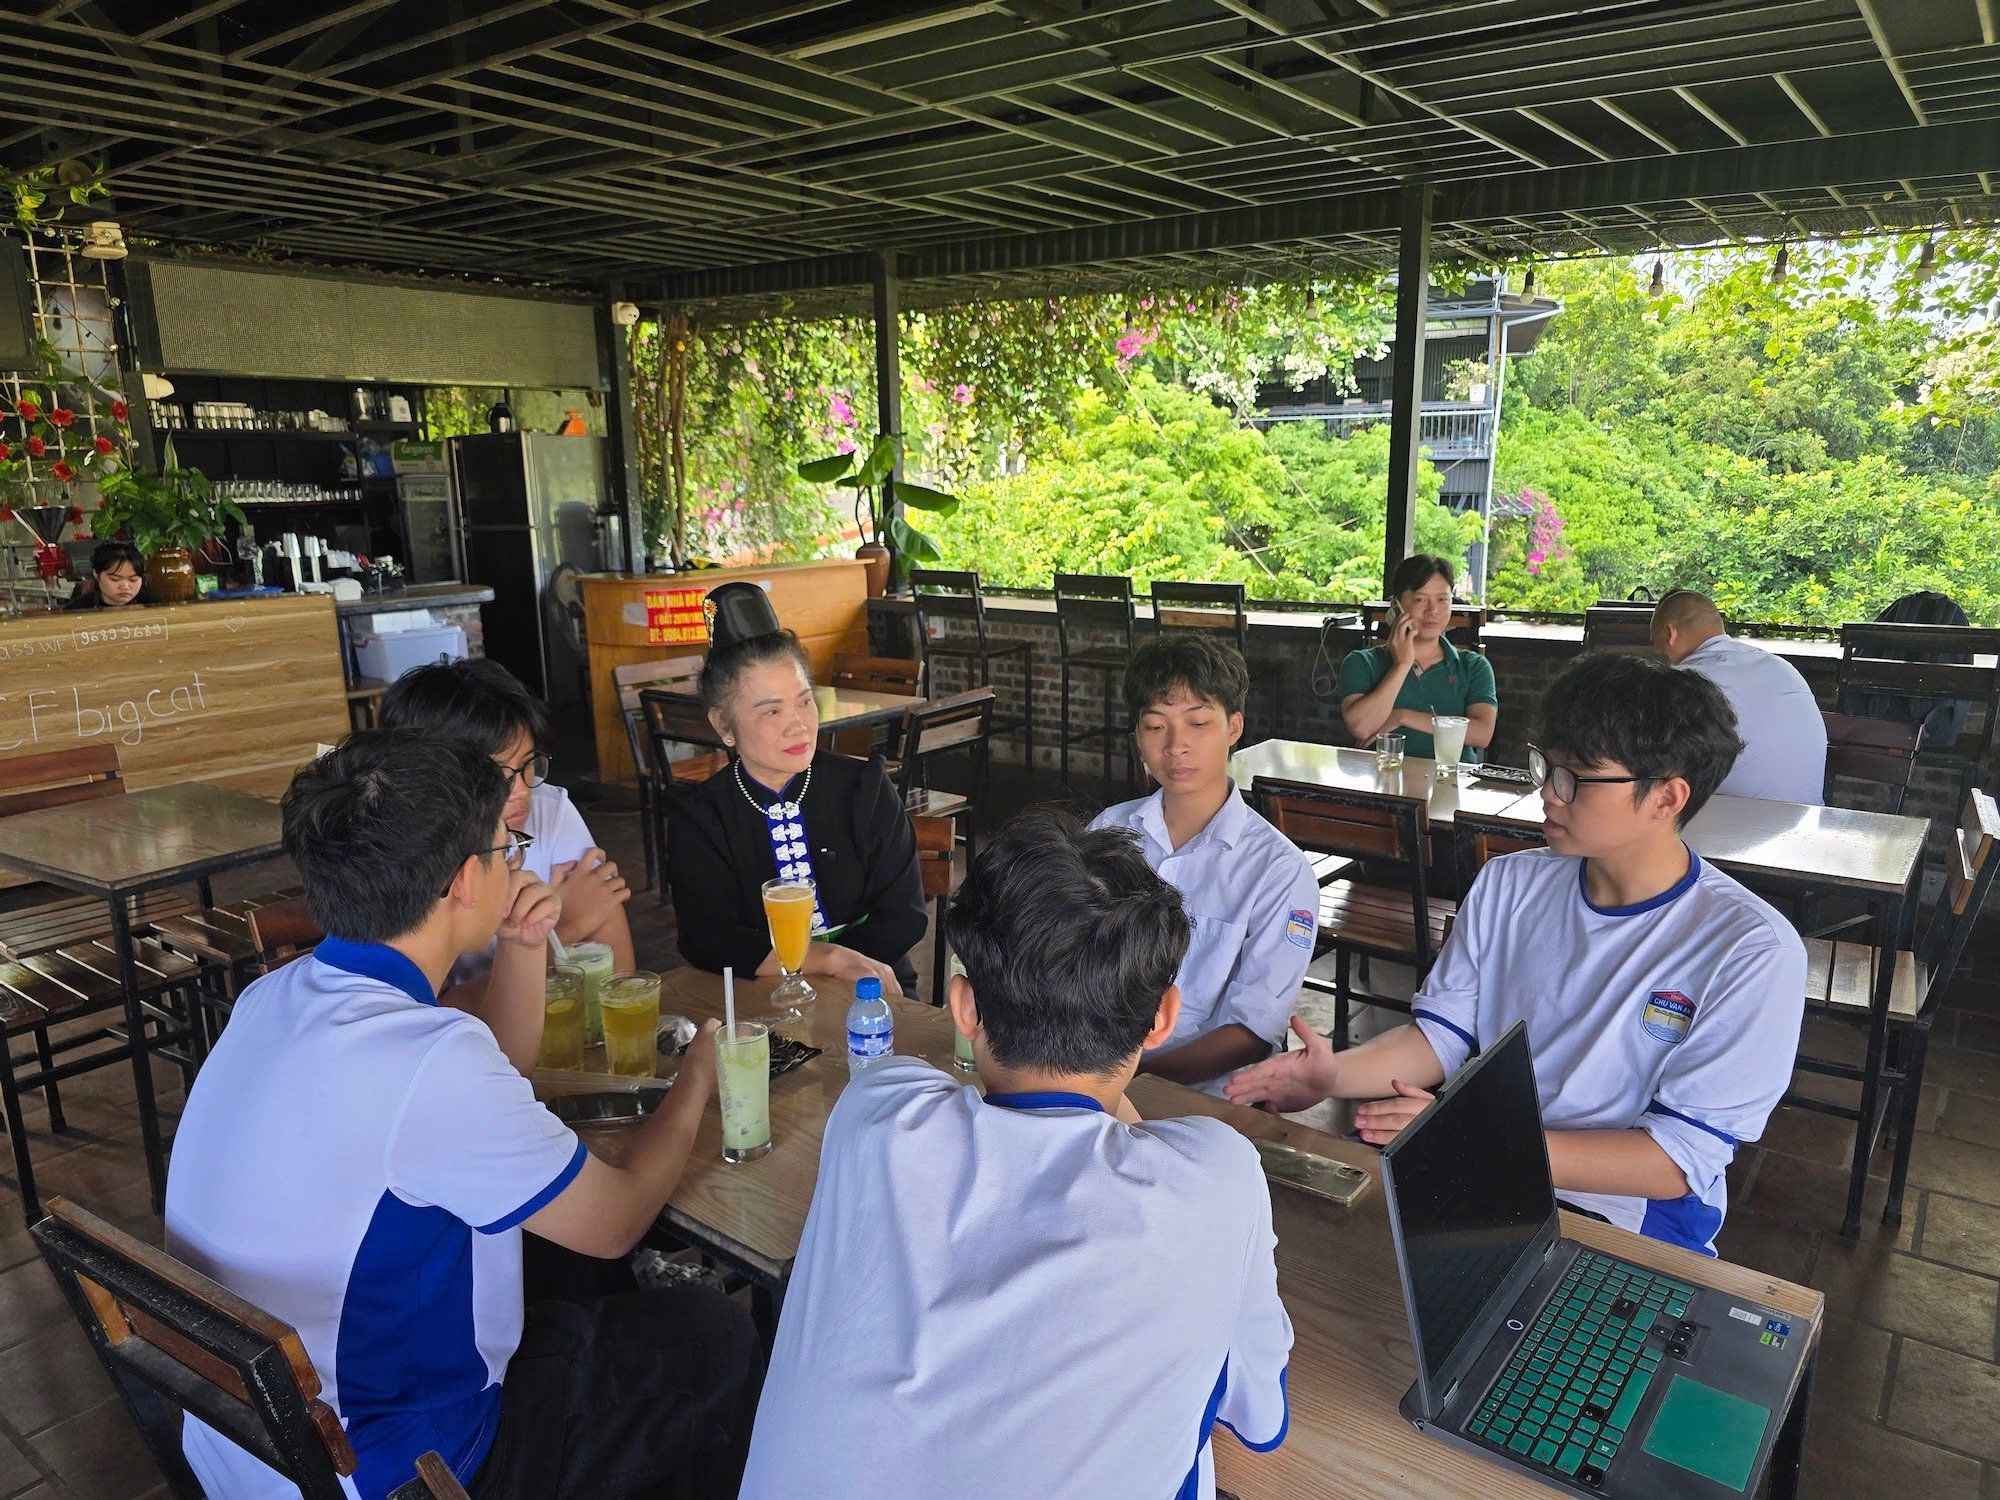
Các em đến Bảo tàng Sơn La tìm hiểu việc lưu giữ, số hóa văn bản cổ; trò chuyện với những người am hiểu chữ Thái; tham gia các buổi học cùng học sinh địa phương và thử nghiệm phần mềm ngay với những người có thể sử dụng nó trong tương lai.
Đó cũng là cách nhóm kiểm chứng một điều rất thực tế: Một công cụ bảo tồn ngôn ngữ chỉ thực sự có giá trị khi cộng đồng thấy nó hữu ích.
Để lớp trẻ có thêm một cách học chữ của ông bà
Một trong những khó khăn của việc truyền dạy chữ viết truyền thống hiện nay là môi trường sử dụng đã thay đổi.
Thế hệ trẻ học tập, giao tiếp và tìm kiếm thông tin ngày càng nhiều trên điện thoại, máy tính. Trong khi đó, tài liệu chữ Thái trên môi trường số còn hạn chế; công cụ hỗ trợ nhập liệu, nhận dạng hay tra cứu chưa phổ biến như đối với tiếng Việt hoặc những ngôn ngữ lớn.
Điều này khiến việc tiếp cận chữ viết dân tộc trở nên khó hơn, đặc biệt với những người trẻ không còn thường xuyên sử dụng chữ Thái trong sinh hoạt hằng ngày.
Từ thực tế đó, nhóm VietTrans đặt mục tiêu xây dựng một hệ thống gồm bộ gõ, từ điển, công cụ chuyển đổi font, nhận dạng chữ từ ảnh và dịch giữa tiếng Thái Đen với tiếng Việt.
Chẳng hạn, một học sinh gặp một đoạn chữ Thái trong cuốn sách cũ có thể chụp lại bằng điện thoại, đưa hình ảnh vào hệ thống để chuyển thành văn bản số, sau đó tra cứu hoặc đối chiếu với tiếng Việt.
Giáo viên có thể sử dụng các công cụ tương tự để chuẩn bị tài liệu song ngữ. Người nghiên cứu có thể tiết kiệm thời gian khi xử lý những văn bản đã được chụp lại nhưng chưa được số hóa.
Xa hơn, những người trẻ sống xa quê vẫn có thể tiếp cận chữ viết của dân tộc mình thông qua các công cụ trực tuyến.
Công nghệ, theo cách ấy, không thay thế người dạy chữ hay những nghệ nhân am hiểu văn hóa truyền thống. Nó đóng vai trò như một cây cầu giúp việc học và sử dụng chữ thuận tiện hơn.
Từ những trang sách cũ đến dữ liệu số
Phần khó nhất của VietTrans không phải viết chương trình, mà là dữ liệu.
Trong khi những ngôn ngữ phổ biến có lượng văn bản số khổng lồ để huấn luyện các mô hình trí tuệ nhân tạo, tài liệu tiếng Thái Đen trên Internet còn rất ít.
Nguồn tư liệu lại nằm rải rác ở nhiều nơi: Bảo tàng, các công trình nghiên cứu, tài liệu địa phương và trong những gia đình còn lưu giữ sách cổ.
Nhiều văn bản đã được đánh máy từ trước nhưng sử dụng các bộ Font khác nhau, chưa theo cùng một chuẩn. Những tài liệu khác chỉ tồn tại dưới dạng sách viết tay, bản in cũ hoặc ảnh chụp.
Vì vậy, nhóm phải thực hiện một công việc khá âm thầm: Tìm tài liệu, chuyển đổi Font, kiểm tra từng ký tự, làm sạch dữ liệu rồi đối chiếu các câu tiếng Thái với tiếng Việt.
“Khó nhất với nhóm không phải là viết Code mà là tìm và làm sạch từng trang dữ liệu”, Long nói.
Cũng từ quá trình này, các em nhận ra một vấn đề lớn hơn: Muốn một ngôn ngữ hiện diện lâu dài trong thời đại số, trước hết phải có một kho dữ liệu đủ tốt và được chuẩn hóa.
Mỗi cuốn sách được số hóa, mỗi đoạn văn được kiểm tra chính xác hay mỗi từ được cộng đồng đóng góp đều có thể trở thành một phần của kho dữ liệu ấy.
Vì thế, VietTrans cũng xây dựng một không gian để người dùng cùng tham gia đóng góp và hiệu chỉnh dữ liệu thay vì để toàn bộ công việc chỉ nằm trong tay một nhóm kỹ thuật.
AI học chữ Thái từ cộng đồng
Nhóm sử dụng và tinh chỉnh mô hình dịch đa ngôn ngữ NLLB để máy có thể học cách dịch giữa tiếng Thái Đen và tiếng Việt.
Song song với đó là hệ thống nhận dạng ký tự quang học, hay OCR, dành cho chữ Thái cổ. OCR đặc biệt quan trọng bởi một phần lớn kho tư liệu chữ Thái hiện vẫn nằm trên giấy.
Khi một trang sách được máy nhận dạng thành văn bản số, nội dung đó có thể được tìm kiếm, chỉnh sửa, lưu trữ thuận tiện hơn và tiếp tục trở thành dữ liệu phục vụ nghiên cứu.
Nhóm đang hướng tới bước tiếp theo là nhận dạng và tổng hợp giọng nói tiếng Thái Đen.
Nếu thực hiện được, người lớn tuổi không quen sử dụng bàn phím có thể nói tiếng Thái để nhập nội dung; người học có thể nghe máy đọc văn bản và luyện phát âm.
Nhưng chính ở đây, vai trò của cộng đồng càng trở nên quan trọng.
Máy tính không thể tự biết cách phát âm đúng tiếng Thái nếu không có giọng nói của người Thái. Nó cũng không thể hiểu sự khác biệt về cách nói giữa các vùng nếu không có người bản địa tham gia ghi âm, kiểm tra và hiệu chỉnh.
Bởi vậy, hành trình “dạy AI tiếng Thái” về bản chất cũng là hành trình tập hợp tri thức đang nằm trong chính cộng đồng. Người biết chữ vẫn là người giữ chìa khóa
Cô Lò Mai Cương - người tham gia biên soạn sách dạy chữ Thái, đánh giá việc ứng dụng công nghệ vào hỗ trợ đọc và học chữ Thái là hướng đi có ý nghĩa thực tế.
Theo cô, hiện nay những người muốn đọc sách cổ, tìm hiểu tài liệu hoặc nghiên cứu chữ Thái trong nhiều trường hợp vẫn phải tìm đến những người biết chữ, các nghệ nhân hoặc chuyên gia để được hướng dẫn.
Nếu các công cụ nhận dạng, tra cứu và dịch thuật được hoàn thiện với độ chính xác cao, không chỉ người Thái mà sinh viên, nhà nghiên cứu và những người quan tâm tới văn hóa Thái cũng có thêm một phương tiện tiếp cận nguồn tư liệu.
Tuy nhiên, công nghệ chỉ có thể hỗ trợ. Những người am hiểu chữ viết, tiếng nói và văn hóa của cộng đồng vẫn là người quyết định một chữ được đọc đúng hay sai, một câu được hiểu đúng hay lệch nghĩa.
Đó cũng là lý do nhóm VietTrans dành thời gian gặp những người trực tiếp nghiên cứu và giảng dạy tiếng Thái, thay vì chỉ thu thập dữ liệu trên mạng rồi để máy tự học.
VietTrans hiện đã được đưa lên môi trường trực tuyến tại viettrans.info để người dùng thử nghiệm các chức năng nhận dạng, chuyển đổi, tra cứu và dịch thuật.
Nhóm muốn trong tương lai đây không chỉ là một trang dịch tự động, mà trở thành một hệ sinh thái hỗ trợ tiếng Thái Đen trên môi trường số, gồm dữ liệu, từ điển, bộ gõ, nhận dạng chữ viết, dịch máy, giọng nói và các công cụ để những ứng dụng khác có thể sử dụng.